# 使用 Amazon Bedrock 构建 RAG 和 Text2SQL AI 应用程序
## 概述
> [!IMPORTANT]
> 本实验将授予您临时访问 Amazon Bedrock 的权限,以调用必要的模型。请严格遵守实验材料中概述的使用指南,并避免在任何其他情境中使用此访问权限。对于任何导致财务损失的 Amazon Bedrock 权限滥用行为,我们保留追究用户法律责任的权利。
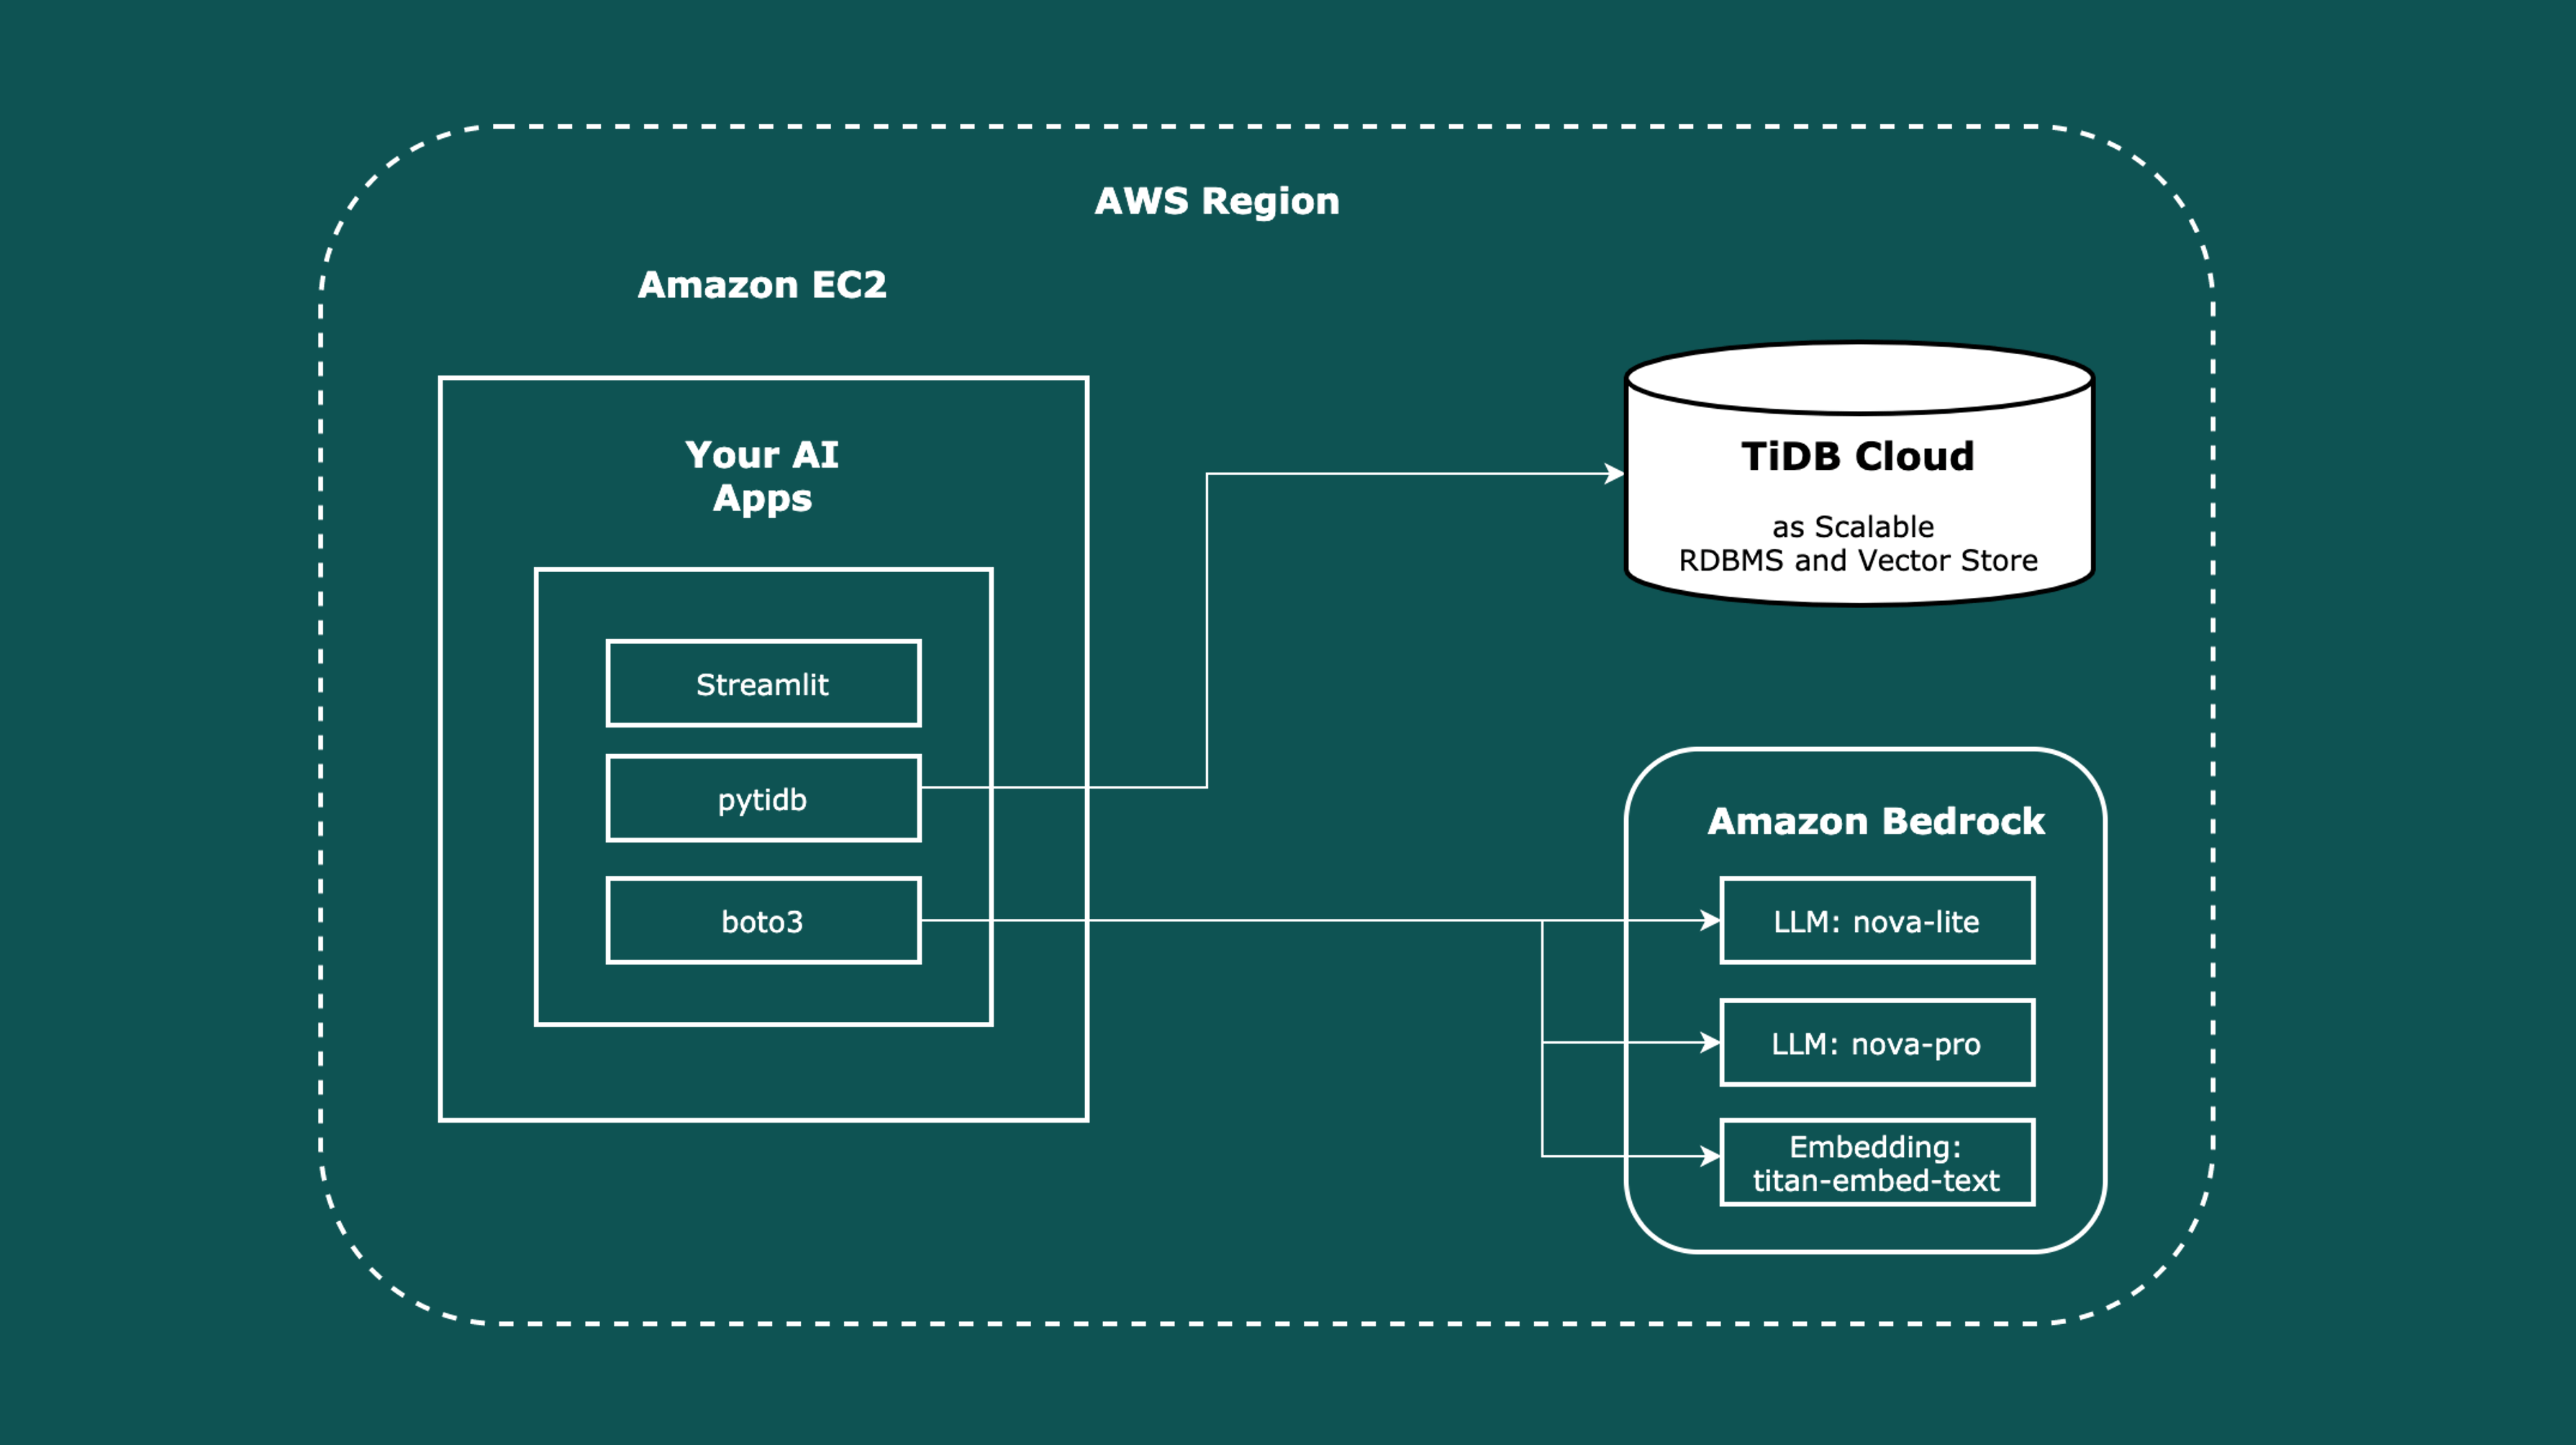
生成式 AI 目前是一个前沿领域,吸引了许多渴望探索的开发者。然而,几个障碍常常阻碍他们进入这个领域,例如:
- 缺乏 AI 基础知识,使他们不确定从何处开始。
- 缺少全面、循序渐进且互动的构建生成式 AI 应用程序指南。
- 学习所需的基础设施有限,如数据库和大型模型 API。
为了解决这些挑战,我们开发了一系列实验,包括本实验,通过这些实验,您将学习:
- 如何利用 pytidb 和 **TiDB Cloud Serverless** 作为 AI 应用程序的统一数据存储层,以简化开发。
- 什么是嵌入(Embedding)及其功能。
- 如何在获取嵌入向量后使用它们。
- 如何在处理大量数据时使用 RAG(检索增强生成)进行信息检索,以及如何使用 LLM(大型语言模型)。
- 如何制作有用的 Text2SQL AI 应用程序来探索数据集。
> [!NOTE]
> 在本实验中,我们将使用 Streamlit 作为快速应用程序开发框架,以简化和加速数据应用程序的构建。
> 无论您选择自己的 TiDB Cloud Serverless 集群还是沙盒 TiDB Cloud Serverless 选项来开始实验,都将为此动手实验创建一个专用数据库。
### 任务
- **构建您的第一个 RAG 应用程序**
- 将您的嵌入向量和其他数据保存到 TiDB Cloud Serverless 集群。
- 启动 Streamlit 网页以测试您的 RAG 应用程序的性能。
- 阅读 RAG 演示的代码。
- **构建您的第一个 Text2SQL 应用程序**
- 使用 TiDB Cloud Serverless 集群作为 SQL 运行器来纠正 LLM。
- 启动 Streamlit 网页以使用您的 Text2SQL 应用程序。
- 阅读 Text2SQL 演示的代码。
### 实验时长
- 完成此练习大约需要 90 分钟。
> [!TIP]
> 点击 **开始** 启动实验。实验环境准备就绪后。点击底部栏上的 **前进** 进入 **模块 1**。
## 模块 1: 准备运行 Python 代码
### 步骤 1. 检查实验环境
- 点击左侧的 `实验资源` 按钮查看为您的实践设置的实验环境。您将看到:
- 一个名为 **monitor1** 的服务器,运行着 VS Code 服务器,它既是开发服务器又是应用服务器。
- TiDB Cloud Serverless 集群的连接详情 — 根据您的选择,可能来自您自己的 TiDB Cloud 账户或实验的沙盒环境。
- 此外,此动手实验的数据库名称为 `${LAB:SERVERLESS_CLUSTER_DATABASE_NAME}`,它将在您选择的 TiDB Cloud Serverless 集群中代您创建。
- 关闭 `实验资源` 弹出窗口。
### 步骤 2. 在 IDE 中打开终端
- 点击[此处](${LAB:SECURITY_ACCESS_PROXY_URL}?next=${LAB:"/vscode/?folder=/root/tidb-lab-ai"|urlencode})在新的浏览器窗口中打开此实验的 VS Code 环境。
- 在弹出的窗口中点击 `Yes, I trust the authors`(是的,我信任作者)。

- 点击左上角的 `≡`,选择 `Terminal`,然后点击 `New Terminal` 打开一个新的终端窗口。

### 步骤 3. 安装 Python 依赖
- 安装依赖。
```bash
pip install --upgrade pip
pip install -r requirements.txt
```
```output
...
Collecting aiohappyeyeballs==2.6.1 (from -r requirements.txt (line 1))
Downloading aiohappyeyeballs-2.6.1-py3-none-any.whl.metadata (5.9 kB)
Collecting aiohttp==3.11.16 (from -r requirements.txt (line 2))
Downloading aiohttp-3.11.16-cp311-cp311-manylinux_2_17_x86_64.manylinux2014_x86_64.whl.metadata (7.7 kB)
Collecting aiosignal==1.3.2 (from -r requirements.txt (line 3))
Downloading aiosignal-1.3.2-py2.py3-none-any.whl.metadata (3.8 kB)
...
```
- 验证管理 TiDB 作为 AI 应用程序统一数据存储的模块 pytidb 也已安装。
```bash
pip list | grep -i pytidb
```
```output
pytidb 0.0.4
```
## 模块 2: 运行、体验和研究 RAG 演示应用程序
运行一个 RAG 演示应用程序,该应用程序连接到 TiDB Cloud Serverless,保存您的嵌入向量,检索相关数据,并生成对您查询的回答。
### 步骤 1. 运行 RAG Streamlit 服务
- 在 VS Code 终端中,使用 `streamlit` 命令行工具运行以下脚本来启动 Streamlit 服务。
```bash
streamlit run bedrock/rag.py --server.port 8501
```
```output
Collecting usage statistics. To deactivate, set browser.gatherUsageStats to false.
You can now view your Streamlit app in your browser.
Local URL: http://localhost:8501
Network URL: http://172.17.0.2:8501
External URL: http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8501
```

### 步骤 2. 使用 RAG 演示网页
- 点击访问您的 [RAG 演示网页](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8501/)。根据实验环境设置,初始化完成大约需要 **5 分钟**。

- 打开名为 `All Chunks in the Database` 的文件夹,以查看当前 TiDB Cloud Serverless 集群中的数据。由于我们尚未保存任何数据,所以它应该是空的。

- 点击 `Save Data` 保存我们为此演示准备的示例文本数据。您可以在下一步中看到示例数据,这是一个字符串列表。
- 保存数据后,您可以在 `All Chunks in the Database` 文件夹中看到 TiDB Cloud Serverless 集群中的数据。我们有 3 列,分别是 `id`、`text` 和 `text_vec`。

- 如果您只想检索上下文,可以点击 `Retrieval Only` 选项。然后,输入您的问题。
- 假设我想问一个问题:
```text
What is TiDB?
```
- 点击 `Send` 按钮开始检索。

- 如您所见,`TiDB is a distributed SQL database with HTAP capabilities.`(TiDB 是一个具有 HTAP 能力的分布式 SQL 数据库)具有最高的相似度分数。
> [!NOTE]
> 您可以按下按钮并拖动列头来更改表格的排序。
> 您还可以将数据下载为 CSV 表格。

- 最后,让我们尝试让 RAG 给我们提供答案。
- 在左上角将 `Retrieval Limit`(检索限制)更改为 `1`,这意味着我们将只检索与您输入的问题最相似的文本。

- 将选项更改为 `RAG Q&A`,然后点击 `Send`。
- 这次,演示将给我们提供答案,而不是材料列表。

### 步骤 3. RAG 演示代码阅读
让我们回到 [VS Code](${LAB:SECURITY_ACCESS_PROXY_URL}?next=${LAB:"/vscode/?folder=/root/tidb-lab-ai"|urlencode}) 并点击代码文件 `bedrock/rag.py`。
1. 脚本首先导入必要的库:用于环境变量的 `os`,用于数据操作的 `pandas`,用于与 LLM 交互的 `litellm`,用于 Web 界面的 `streamlit`,以及来自 `pytidb` 的组件,用于将 TiDB 作为统一的持久数据存储。
```python
import os
import pandas as pd
from litellm import completion
import streamlit as st
from typing import Optional, Any
from pytidb import TiDBClient
from pytidb.schema import TableModel, Field
from pytidb.embeddings import EmbeddingFunction
```
2. 定义了一个名为 `RAG_PROMPT_TEMPLATE` 的提示模板。这个模板将用于构建输入给 LLM 的结构,为其提供上下文和用户的问题以生成答案。
```python
# RAG prompt template
RAG_PROMPT_TEMPLATE = """Answer the question based on the following reference information.
Reference Information:
{context}
Question: {question}
Please answer:"""
```
3. 使用 `TiDBClient.connect()` 建立与 TiDB Cloud Serverless 集群的连接。连接参数如主机、端口、用户名、密码和数据库名称都是从环境变量(例如 `SERVERLESS_CLUSTER_HOST`)中获取的。启用了 SSL 以确保连接安全。
```python
db = TiDBClient.connect(
host=os.getenv("SERVERLESS_CLUSTER_HOST"),
port=int(os.getenv("SERVERLESS_CLUSTER_PORT")),
username=os.getenv("SERVERLESS_CLUSTER_USERNAME"),
password=os.getenv("SERVERLESS_CLUSTER_PASSWORD"),
database=os.getenv("SERVERLESS_CLUSTER_DATABASE_NAME"),
enable_ssl=True,
)
```
4. 定义了嵌入模型和 LLM。对于本实验,我们使用 Amazon Bedrock 模型:
- `text_embed`:使用 `bedrock/amazon.titan-embed-text-v2:0` 初始化了一个 `EmbeddingFunction`,用于生成文本嵌入。为嵌入过程设置了 60 秒的超时时间。
- `llm_model`:变量 `llm_model` 设置为 `bedrock/us.amazon.nova-lite-v1:0`,将用于生成答案。
```python
text_embed = EmbeddingFunction(
"bedrock/amazon.titan-embed-text-v2:0",
timeout=60
)
llm_model = "bedrock/us.amazon.nova-lite-v1:0"
```
5. 使用 `pytidb.schema.TableModel` 定义了一个 `Chunk` 表模式。这个名为 `chunks` 的表将用于存储我们的数据。
- `id`:一个整数字段,作为主键。
- `text`:一个字符串字段,用于存储原始文本块。
- `text_vec`:一个向量字段,将自动存储 `text` 字段的嵌入向量,这些嵌入向量由前面定义的 `text_embed` 函数生成。
```python
# Define the Chunk table
table_name = "chunks"
class Chunk(TableModel, table=True):
__tablename__ = table_name
__table_args__ = {"extend_existing": True}
id: int = Field(primary_key=True)
text: str = Field()
text_vec: Optional[Any] = text_embed.VectorField(
source_field="text",
)
```
6. 提供了一个 `sample_chunks`(字符串)列表。在实际应用中,这些文本块通常是通过一个称为"分块"(chunking)的过程从更大的文档中提取出来的。
```python
sample_chunks = [
"Llamas are camelids known for their soft fur and use as pack animals.",
"Python's GIL ensures only one thread executes bytecode at a time.",
# ... (other sample chunks)
"Augmented reality overlays digital content on the real world.",
]
```
7. 脚本尝试打开 `chunks` 表。如果该表在数据库中不存在(例如,在首次运行时),它会根据之前定义的 `Chunk` 模式创建表。这确保表已准备好进行数据操作。
```python
table = db.open_table(table_name)
if table is None:
table = db.create_table(schema=Chunk)
```
8. 设置了 Streamlit 用户界面。页面标题设置为 `🔍 RAG Demo`,并添加了一个子标题 `Database Operations`。
```python
st.title("🔍 RAG Demo")
st.subheader("Database Operations")
```
9. 创建了两个用于数据库操作按钮的列:
- `Reset`:点击时,此按钮会截断(清除所有数据)`chunks` 表,并重新运行 Streamlit 应用程序以刷新视图。下方显示了一条警告消息。
- `Save Data`:点击时,如果表当前为空,此按钮会将 `sample_chunks` 插入表中。根据 `text_vec` 字段的定义,`pytidb` 在插入时会自动调用 Bedrock 嵌入模型来向量化 `text` 数据。然后应用程序会重新运行。
```python
left, right = st.columns(2)
if left.button("Reset", type="primary"):
left.write("Resetting...")
table.truncate()
st.rerun()
left.markdown("This option will delete all data", unsafe_allow_html=True)
if right.button("Save Data"):
right.write("Saving...")
# insert sample chunks
if table.rows() == 0:
chunks = [Chunk(text=text) for text in sample_chunks]
table.bulk_insert(chunks)
st.rerun()
```
10. 创建了一个标记为 `📁 All Chunks in the Database`(数据库中的所有文本块)的可展开部分。当展开时,它会查询 `table` 中的所有行,将数据转换为 Pandas DataFrame,并显示出来。如果表为空,则显示一条信息提示。
```python
with st.expander("📁 All Chunks in the Database", expanded=False):
chunks = table.query()
if chunks:
data = [{'id': chunk.id, 'text': chunk.text, 'text_vec': chunk.text_vec} for chunk in chunks]
df = pd.DataFrame(data)
st.dataframe(df)
else:
st.info("No data found in database.")
```
11. 添加了指导文本和用户输入元素:
- 单选按钮(`mode`)允许用户选择操作模式:`Retrieval Only`(仅检索)或 `RAG Q&A`(RAG 问答)。
- 侧边栏中的滑块(`query_limit`)让用户可以调整要检索的文本块数量(默认为 5,最小 1,最大 20)。
- 文本输入框(`query`)提示用户输入他们的问题。
```python
st.write(
"Enter your question, and the system will retrieve relevant knowledge and generate an answer"
)
mode = st.radio("Select Mode:", ["Retrieval Only", "RAG Q&A"])
query_limit = st.sidebar.slider("Retrieval Limit", min_value=1, max_value=20, value=5)
query = st.text_input("Enter your question:", "")
```
12. 此代码块处理用户点击 `Send` 按钮并输入查询时的逻辑:
- 处理过程中显示一个加载动画。
- 核心操作 `table.search(query).limit(query_limit)` 使用用户的查询在 `text_vec` 列上执行向量相似度搜索,并检索相似度最高的前 `query_limit` 个文本块。
```python
if st.button("Send") and query:
with st.spinner("Processing..."):
# Retrieve relevant chunks
res = table.search(query).limit(query_limit)
```
13. 根据所选的 `mode`(模式)和是否找到结果(`res`):
- 如果是 `Retrieval Only`(仅检索):直接显示检索到的文本块(转换为 Pandas DataFrame)。
- 如果是 `RAG Q&A`(RAG 问答):
- 从检索到的文本块中提取 `text` 内容。
- 通过连接这些文本构建 `context`(上下文)。
- 使用这个 `context` 和用户的 `question`(问题)格式化 `RAG_PROMPT_TEMPLATE`。
- 通过 `litellm.completion` 调用 Bedrock LLM(由 `llm_model` 指定)并传入构建的提示来生成答案。
- 使用自定义 CSS 样式显示 LLM 的响应。
- 一个可展开的部分(`📚 Retrieved Knowledge`)显示用于生成答案的文本块。
- 如果初始搜索没有返回结果,则显示信息提示 `No relevant information found`(未找到相关信息)。
```python
if res:
if mode == "Retrieval Only":
st.write("### Retrieval Results:")
st.dataframe(res.to_pandas())
else:
text = [chunk.text for chunk in res.to_rows()]
# Build RAG prompt
context = "\n".join(text)
prompt = RAG_PROMPT_TEMPLATE.format(context=context, question=query)
# Call LLM to generate answer
response = completion(
model=llm_model,
messages=[{"content": prompt, "role": "user"}],
)
st.markdown(f"### 🤖 {llm_model}")
st.markdown(
"""
""",
unsafe_allow_html=True,
)
# show the response
st.markdown(
f'{response.choices[0].message.content}
',
unsafe_allow_html=True,
)
with st.expander("📚 Retrieved Knowledge", expanded=False):
st.dataframe(res.to_pandas())
else:
st.info("No relevant information found")
```
## 模块 3:运行、体验和学习 Text2SQL 演示应用程序
接下来的演示,我们将深入探索另一种 GenAI 应用程序。它使用 TiDB Cloud Serverless 集群作为 SQL 验证器。它将:
1. 从您的查询生成 SQL。
2. 在 TiDB Cloud Serverless 集群上运行它。
3. 从 TiDB Cloud Serverless 集群获取反馈或错误消息。
4. 自我纠正直到找到可靠的结果。
### 步骤 1. 运行 Text2SQL Streamlit 服务
创建一个新的终端:

然后使用 `streamlit` 命令行工具运行此脚本:
```bash
streamlit run bedrock/text2sql.py --server.port 8502
```
```output
Collecting usage statistics. To deactivate, set browser.gatherUsageStats to false.
You can now view your Streamlit app in your browser.
Local URL: http://localhost:8502
Network URL: http://172.17.0.2:8502
External URL: http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8502
```
### 步骤 2. 使用 Text2SQL 演示网页
- 打开您的 [Text2SQL 演示网页](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8502/)。

- 然后,我们可以询问有关此数据集的问题,例如:
```text
数据库中有多少个表?
```
- 点击 Enter 键生成 SQL 并在 TiDB Cloud Serverless 集群上运行它。

- 或者,您可以尝试另一个问题,如:
```text
数据库中的表名是什么?
```

- 这是因为我们运行了模块 2,并在那里创建了 `chunks` 表。
- 您可以尝试一些您想要询问有关此数据集的问题。
### 步骤 3. Text2SQL 演示代码阅读
再次,让我们回到 [VS Code](${LAB:SECURITY_ACCESS_PROXY_URL}?next=${LAB:"/vscode/?folder=/root/tidb-lab-ai"|urlencode}) 并点击代码文件 `bedrock/text2sql.py`。
1. 脚本导入必要的库:`os` 用于环境变量,`boto3` 用于与 AWS 服务交互(特别是 Bedrock),`streamlit` 用于 UI,以及来自 `pytidb` 的 `TiDBClient` 用于数据库连接。
```python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
import os
import boto3
import streamlit as st
from pytidb import TiDBClient
```
2. 为 Streamlit 应用程序页面设置标题 `## 📖 Text2SQL`。
```python
st.markdown("## 📖 Text2SQL")
```
3. 建立了一个到 TiDB Cloud Serverless 集群的 `TiDBClient` 连接。连接详情(主机、端口、用户名、密码、数据库)从环境变量中读取。连接启用了 SSL。
```python
db = TiDBClient.connect(
host=os.getenv("SERVERLESS_CLUSTER_HOST"),
port=int(os.getenv("SERVERLESS_CLUSTER_PORT")),
username=os.getenv("SERVERLESS_CLUSTER_USERNAME"),
password=os.getenv("SERVERLESS_CLUSTER_PASSWORD"),
database=os.getenv("SERVERLESS_CLUSTER_DATABASE_NAME"),
enable_ssl=True,
)
```
4. 初始化了一个用于 Amazon Bedrock 运行时的 `boto3` 客户端,特别是针对 `us-west-2` 区域。这个客户端将用于调用 Bedrock 模型。
```python
client = boto3.client(
service_name="bedrock-runtime",
region_name="us-west-2"
)
```
5. 初始化 Streamlit 的会话状态以存储聊天历史。如果它们尚不存在,则创建两个列表,`generated`(用于助手的消息)和 `past`(用于用户的消息)。
```python
for item in ["generated", "past"]:
if item not in st.session_state:
st.session_state[item] = []
```
6. 从连接的 TiDB 数据库中获取表定义。脚本遍历所有表名,对每个表执行 `SHOW CREATE TABLE`,并将 DDL 语句存储在 `table_definitions` 列表中。同时还检索了 `current_database` 名称。这些信息为 LLM 提供了架构上下文。
```python
table_definitions = []
current_database = db._db_engine.url.database
for table_name in db.table_names():
table_definitions.append(db.query(f"SHOW CREATE TABLE `{table_name}`").to_rows()[0])
```
7. 定义了一个辅助函数 `format_answer`。该函数通过移除前导/尾随代码块标记(如 \`\`\`sql 或 \`\`\`)来清理 LLM 的响应,确保 SQL 或 markdown 是干净的。
```python
def format_answer(answer: str) -> str:
# Handle ```.* specifically
if answer.startswith("```"):
# Find the first newline after the opening ```
first_newline = answer.find("\n")
if first_newline != -1:
# Remove everything from start to the newline
answer = answer[first_newline:].strip()
# Remove closing ``` if present
if answer.endswith("```"):
answer = answer[:-len("```")].strip()
return answer
```
8. 定义了 `on_submit` 函数。当用户提交问题时会调用此函数。
- 它从会话状态中检索 `user_input`。
- 它使用 `client.converse` 调用 Amazon Bedrock 模型 `us.amazon.nova-pro-v1:0` 来生成 SQL 查询。系统提示指导模型扮演高级 DBA 角色,使用提供的表定义和数据库名称,并直接以 SQL 形式响应,不包含额外文本。
- 从响应中提取生成的 SQL 并使用 `format_answer` 进行清理。
- 用户的输入被添加到 `st.session_state.past` 列表中。
```python
def on_submit():
user_input = st.session_state.user_input
if user_input:
generated_sql = (
client.converse(
modelId="us.amazon.nova-pro-v1:0",
messages=[
{"role": "user", "content": [{"text": f"Question: {user_input}\n Respond in SQL directly, without any other text and format."}]},
],
system=[
{"text": f"""You are a very senior database administrator who can write SQL very well,
please write MySQL SQL to answer user question,
Use backticks to quote table names and column names,
here are some table definitions in database,
the database name is {current_database}\n\n"""
+ "\n".join("|".join(t) for t in table_definitions)}
],
)["output"]["message"]["content"][0]["text"]
)
generated_sql = format_answer(generated_sql)
st.session_state.past.append(user_input)
```
9. 对 `generated_sql` 进行安全检查。如果它包含 `INSERT` 或 `UPDATE`(不区分大小写),将显示错误消息,并且脚本停止执行,防止执行潜在有害的 DML 语句。
```python
if "insert" in generated_sql.lower() or "update" in generated_sql.lower():
st.error(
"The generated SQL is not a SELECT statement, please check it carefully before running it."
)
st.stop()
```
10. 脚本尝试在 TiDB 数据库上执行 `generated_sql`:
- 使用 `try-except` 块处理查询执行过程中可能出现的错误。
- 如果成功,获取数据库查询结果(`rows`)并将其格式化为字符串 `sql_result`。
- 再次调用 Bedrock 模型 `us.amazon.nova-pro-v1:0`。这次,LLM 被提示充当 markdown 格式化器。它接收原始问题、生成的 SQL 和 `sql_result` 作为输入,并被要求将它们格式化为可读的 markdown 响应,包括数据的 markdown 表格。它还被指示避免使用额外的格式化,如代码块。
- LLM 的格式化答案使用 `format_answer` 进行清理,并添加到 `st.session_state.generated` 中。
- 如果在此过程中发生任何异常,错误消息将被添加到 `st.session_state.generated` 中。
```python
# Execute the SQL query and set the result
answer = None
try:
rows = db.query(generated_sql).to_rows()
sql_result = "\n".join(str(row) for row in rows)
answer = (
client.converse(
modelId="us.amazon.nova-pro-v1:0",
messages=[
{"role": "user", "content": [{"text": f"""
Question: {user_input}\n\n
SQL: {generated_sql}\n\n
Result: {sql_result}"""}]},
],
system=[
{"text": """You are a markdown formatter,
format the Question and SQL to markdown text,
format the data row into markdown tables.
NOTE: Without any other format like ``` etc.
"""}
],
)["output"]["message"]["content"][0]["text"]
)
answer = format_answer(answer)
st.session_state.generated.append(answer)
except Exception as e:
st.session_state.generated.append(f"Error: {e}")
```
11. 设置 Streamlit UI 用于用户交互:
- 显示一个子标题 `##### User Query`。
- 使用 `st.container` 将聊天输入和聊天显示区域分组。
- `st.chat_input` 创建一个文本输入字段用于用户提问。`key="user_input"` 将其绑定到会话状态,`on_submit=on_submit` 将其链接到回调函数。
- `st.empty()` 创建一个占位符 (`chat_placeholder`),用于渲染聊天历史。
```python
st.markdown("##### User Query")
with st.container():
st.chat_input(
"Input your question, e.g. how many tables in the database?",
key="user_input",
on_submit=on_submit,
)
chat_placeholder = st.empty()
```
12. 聊天历史记录在 `chat_placeholder` 容器内渲染:
- 它以倒序(最新的在前)遍历 `st.session_state["generated"]`(助手回复)和 `st.session_state["past"]`(用户输入)列表。
- 使用 `st.chat_message("user")` 和 `st.chat_message("assistant")` 来以适当的样式显示每条消息。
```python
with chat_placeholder.container():
for i in range(len(st.session_state["generated"]) - 1, -1, -1):
with st.chat_message("user"):
st.write(st.session_state["past"][i])
with st.chat_message("assistant"):
st.write(st.session_state["generated"][i])
```
### 步骤 4. 前往 TiDB Cloud 控制台开始您自己的旅程
- 创建您自己的 AWS 账户并配置 Amazon Bedrock 超出了本实验的范围。有关详细信息,请参阅 [Amazon Bedrock 文档](https://docs.aws.amazon.com/bedrock/latest/userguide/what-is-bedrock.html)。
- TiDB 及其配套的 GenAI SDK `pytidb` 通过为 GenAI 应用程序提供统一的数据存储来简化开发。您现在可以在[这里](https://tidbcloud.com/clusters)开始您的 TiDB Cloud 之旅。如果您在本实验中使用了自己的免费层集群,您会在同一页面上找到它。下个实验见!
## 结论
在本实验中,您学习了如何使用 Python、TiDB Cloud Serverless 作为统一数据存储以及 Amazon Bedrock 构建两种类型的 AI 应用程序:
- **检索增强生成 (RAG):** 您学习了如何使用 `pytidb` 连接到 TiDB Cloud Serverless,存储文本数据及其由 Amazon Bedrock 的 `bedrock/amazon.titan-embed-text-v2:0` 模型生成的向量嵌入,执行向量相似性搜索以检索相关上下文,并使用大型语言模型 (LLM)(如 `bedrock/us.amazon.nova-lite-v1:0`)基于检索到的上下文生成答案。您还构建了一个 Streamlit 界面来与 RAG 系统交互。
- **文本到 SQL:** 您探索了如何利用 LLM(`bedrock/us.amazon.nova-pro-v1:0`)将自然语言问题转换为 SQL 查询。您学习了如何向 LLM 提供来自 TiDB 的表模式作为上下文,以生成准确的 SQL,对 TiDB 执行生成的查询,并使用另一个 LLM 调用格式化结果。该应用程序也通过 Streamlit 界面呈现。