# Amazon Bedrock を使用した RAG および Text2SQL AI アプリケーションの構築
## 概要
> [!IMPORTANT]
> この演習では、必要なモデルを呼び出すために Amazon Bedrock への一時的なアクセス権が付与されます。演習資料に記載されている使用ガイドラインを厳守し、このアクセスを他の文脈で使用することは控えてください。Amazon Bedrock 権限の誤用により経済的損失が生じた場合、ユーザーに法的責任を問う権利を留保します。
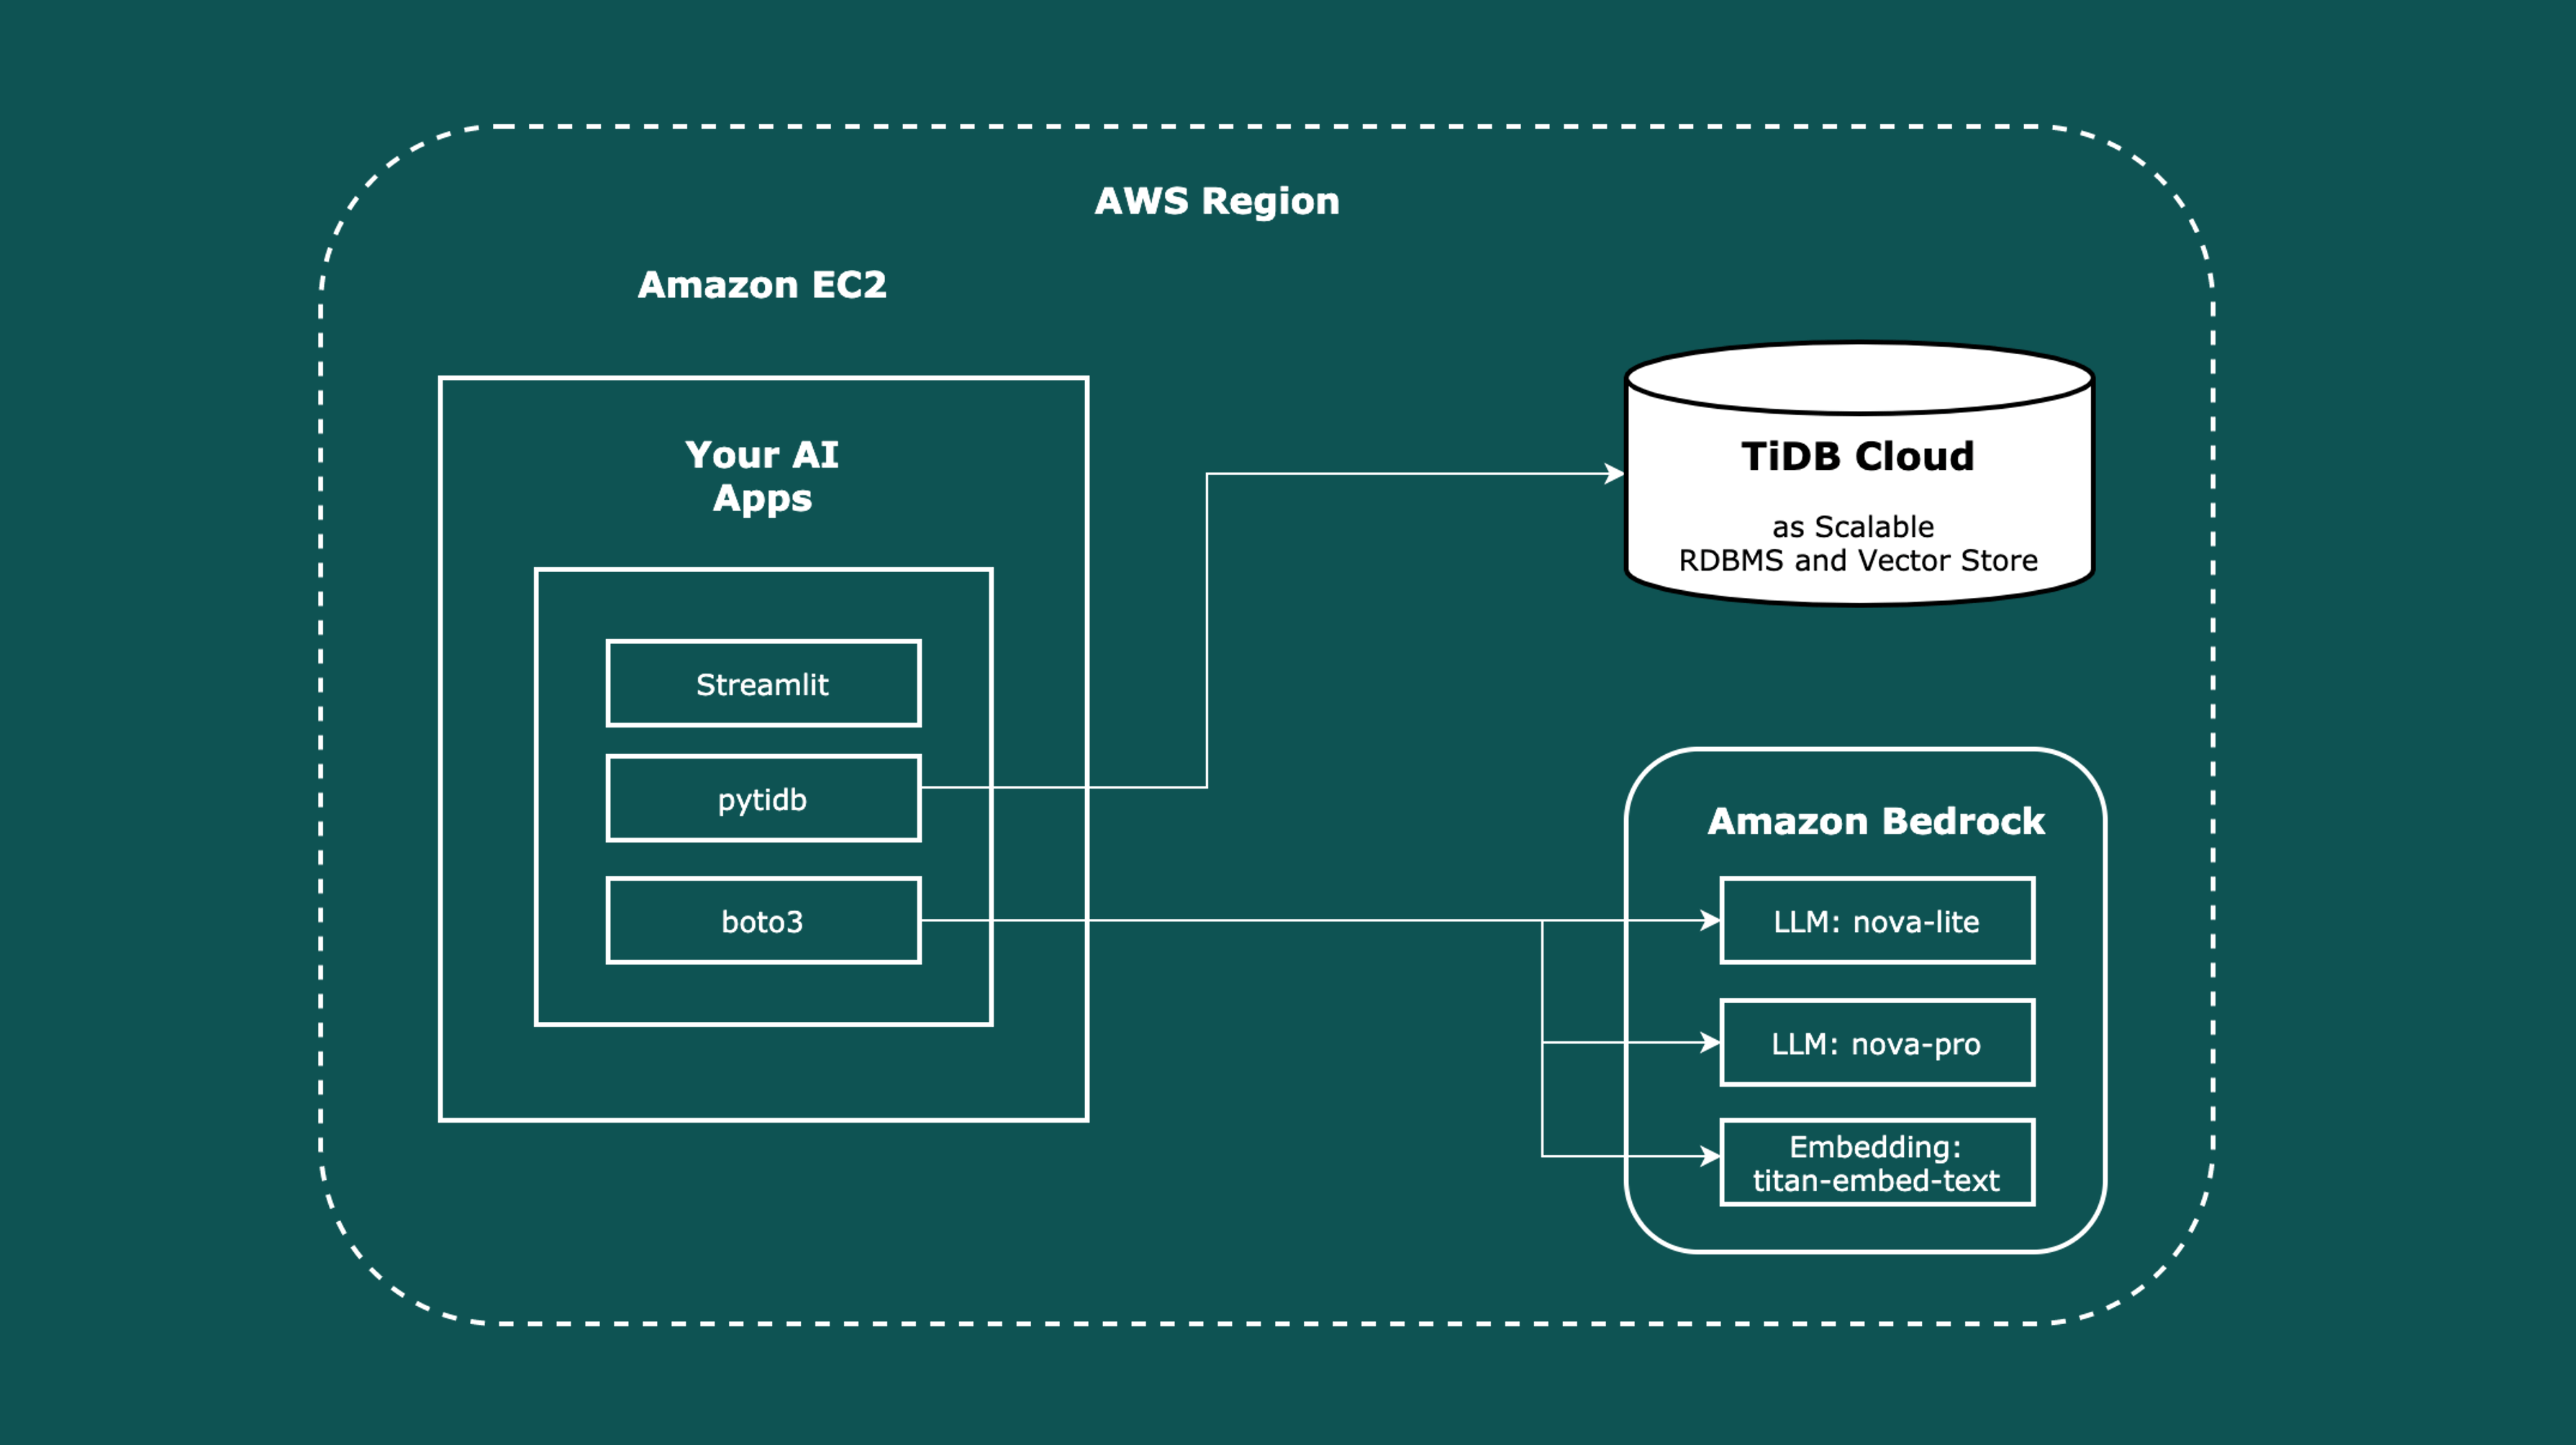
生成 AI は現在、多くの開発者が探求したいと考えている最先端の分野です。しかし、この分野への参入を妨げるいくつかの障壁が存在します:
- AI の基礎知識の不足により、どこから始めればよいか分からない。
- 生成 AI アプリケーションを構築するための包括的で段階的、かつインタラクティブなガイドの欠如。
- データベースや大規模モデル API などの学習に必要な基本的なインフラへのアクセスの制限。
これらの課題に対処するため、この演習を含む一連の演習を開発しました。これらを通じて以下のことを学びます:
- pytidb と **TiDB Cloud Serverless** を AI アプリケーションの統一データストレージレイヤーとして活用し、開発を効率化する方法。
- Embedding(埋め込み)とは何か、そしてその機能。
- 取得した埋め込みベクトルの活用方法。
- 大量のデータを扱う際の情報検索に RAG(Retrieval-Augmented Generation)を採用し、LLM(Large Language Model)と連携する方法。
- データセットを探索するための有用な Text2SQL AI アプリケーションの作成方法。
> [!NOTE]
> この演習では、データアプリケーションの構築を効率化し加速するための迅速なアプリケーション開発フレームワークとして Streamlit を使用します。
> 演習を開始するために自分の TiDB Cloud Serverless クラスタを選択するか、サンドボックスの TiDB Cloud Serverless オプションを選択するかにかかわらず、このハンズオン演習用の専用データベースが作成されます。
### タスク
- **初めての RAG アプリケーションを構築する**
- 埋め込みベクトルとその他のデータを TiDB Cloud Serverless クラスタに保存します。
- Streamlit ウェブページを起動して、RAG アプリケーションのパフォーマンスをテストします。
- RAG デモのコードを読みます。
- **初めての Text2SQL アプリケーションを構築する**
- TiDB Cloud Serverless クラスタを SQL ランナーとして使用して LLM を修正します。
- Streamlit ウェブページを起動して、Text2SQL アプリケーションを使用します。
- Text2SQL デモのコードを読みます。
### 所要時間
+ この演習は約 90 分程度かかります。
> [!TIP]
> 演習環境のデプロイが完了したら、下部のバーにある **次のモジュール** をクリックして、**モジュール 1** に進みます。
## モジュール 1: Python コードの実行準備
### 手順 1. 演習環境を確認する
+ 左側の `演習リソース` ボタンをクリックして、ハンズオン演習用に設定された演習環境を確認します。以下が表示されます:
+ **monitor1** という名前のサーバーで VS Code サーバーが実行されており、開発サーバーとアプリケーションサーバーの両方として機能します。
+ TiDB Cloud Serverless クラスタの接続詳細 — あなたの選択に応じて、あなた自身の TiDB Cloud アカウントまたは演習のサンドボックス環境のいずれかからのものです。
+ さらに、このハンズオン演習用のデータベース名は `${LAB:SERVERLESS_CLUSTER_DATABASE_NAME}` で、選択した TiDB Cloud Serverless クラスタにあなたに代わって作成されます。
+ `演習リソース` ポップアップウィンドウを閉じます。
### 手順 2. IDE でターミナルを開く
+ [こちら](${LAB:SECURITY_ACCESS_PROXY_URL}?next=${LAB:"/vscode/?folder=/root/tidb-lab-ai"|urlencode})をクリックして、この演習用の VS Code 環境を新しいブラウザウィンドウで開きます。
+ ポップアップウィンドウが表示されたら、「Yes, I trust the authors(はい、著者を信頼します)」をクリックしてください。

+ 左上の `≡` をクリックし、次に `Terminal`、そして `New Terminal` をクリックして新しいターミナルを開いてください。

### 手順 3. Python の依存関係をインストールする
+ VS Code ターミナルで以下のコマンドを実行して、必要な依存関係をインストールします。
```bash
pip install --upgrade pip
pip install -r requirements.txt
```
```output
...
Collecting aiohappyeyeballs==2.6.1 (from -r requirements.txt (line 1))
Downloading aiohappyeyeballs-2.6.1-py3-none-any.whl.metadata (5.9 kB)
Collecting aiohttp==3.11.16 (from -r requirements.txt (line 2))
Downloading aiohttp-3.11.16-cp311-cp311-manylinux_2_17_x86_64.manylinux2014_x86_64.whl.metadata (7.7 kB)
Collecting aiosignal==1.3.2 (from -r requirements.txt (line 3))
Downloading aiosignal-1.3.2-py2.py3-none-any.whl.metadata (3.8 kB)
...
```
+ AI アプリケーション用の統一データストアとして TiDB を管理するモジュールもインストールされていることを確認します。
```bash
pip list | grep -i pytidb
```
```output
pytidb 0.0.4
```
## モジュール 2: RAG デモアプリケーションの実行、体験、および学習
TiDB Cloud Serverless に接続する RAG デモアプリケーションを実行し、埋め込みを保存し、関連データを取得し、クエリに対する回答を生成します。
### 手順 1. RAG Streamlit サービスを実行する
次に `streamlit` コマンドラインツールを使用してこのスクリプトを実行します:
```bash
streamlit run bedrock/rag.py --server.port 8501
```
```output
Collecting usage statistics. To deactivate, set browser.gatherUsageStats to false.
You can now view your Streamlit app in your browser.
Local URL: http://localhost:8501
Network URL: http://172.17.0.2:8501
External URL: http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8501
```

### 手順 2. RAG デモウェブページの使用
- [RAG デモウェブページ](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8501/)にアクセスするためにクリックしてください。演習環境のセットアップに基づいて、初期化が完了するまで約**5分**かかります。

- `All Chunks in the Database` フォルダーを開いて、現在 TiDB Cloud Serverless クラスタにあるデータを確認してください。まだデータは保存していないため、空になっているはずです。

- `Save Data`をクリックして、このデモ用に準備したサンプルテキストデータを保存します。次の手順でサンプルデータを確認できます。これは文字列のリストです。
- データを保存した後、TiDB Cloud Serverless クラスタ内のデータが `All Chunks in the Database` フォルダに表示されます。そして、`id`、`text`、`text_vec` の3つの列があります。

- コンテキストのみを取得したい場合は、`Retrieval Only`(検索のみ)オプションをクリックします。その後、質問を入力します。
- 例えば、次のような質問をしたいとします:
```text
What is TiDB?
```
- `Send`ボタンをクリックして検索を開始します。

- ご覧のように、`TiDB is a distributed SQL database with HTAP capabilities.`が最も高い類似度スコアを持っています。
> [!NOTE]
> 列の見出しのボタンを押してドラッグすることで、テーブルの順序を変更できます。
> また、データをCSVテーブルとしてダウンロードすることもできます。

- 最後に、RAGに回答を提供させてみましょう。
- 左上の`Retrieval Limit`を`1`に変更します。これは、入力した質問に対して最も類似したテキストのみを取得することを意味します。

- オプションを`RAG Q&A`に変更し、`Send`をクリックします。
- 今回は、デモは資料リストではなく回答を提供します。

### 手順 3. RAG デモコードの読み取り
[VS Code](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:3000/?folder=/root/tidb-lab-ai) に戻り、コードファイル `bedrock/rag.py` をクリックしましょう。
1. スクリプトは必要なライブラリをインポートすることから始まります:環境変数用の`os`、データ操作用の`pandas`、LLMとの対話用の`litellm`、Webインターフェース用の`streamlit`、そしてTiDBを統一された永続データストアとして活用するための`pytidb`からのコンポーネントです。
```python
import os
import pandas as pd
from litellm import completion
import streamlit as st
from typing import Optional, Any
from pytidb import TiDBClient
from pytidb.schema import TableModel, Field
from pytidb.embeddings import EmbeddingFunction
```
2. `RAG_PROMPT_TEMPLATE`という名前のプロンプトテンプレートが定義されています。このテンプレートは、LLMへの入力を構造化するために使用され、コンテキストとユーザーの質問を提供して回答を生成します。
```python
# RAG prompt template
RAG_PROMPT_TEMPLATE = """Answer the question based on the following reference information.
Reference Information:
{context}
Question: {question}
Please answer:"""
```
3. `TiDBClient.connect()`を使用してTiDB Cloud Serverlessクラスタへの接続が確立されます。ホスト、ポート、ユーザー名、パスワード、データベース名などの接続パラメータは環境変数(例:`SERVERLESS_CLUSTER_HOST`)から取得されます。安全な接続のためにSSLが有効化されています。
```python
db = TiDBClient.connect(
host=os.getenv("SERVERLESS_CLUSTER_HOST"),
port=int(os.getenv("SERVERLESS_CLUSTER_PORT")),
username=os.getenv("SERVERLESS_CLUSTER_USERNAME"),
password=os.getenv("SERVERLESS_CLUSTER_PASSWORD"),
database=os.getenv("SERVERLESS_CLUSTER_DATABASE_NAME"),
enable_ssl=True,
)
```
4. 埋め込みモデルとLLMが定義されています。この演習では、Amazon Bedrockモデルを使用します:
- `text_embed`:テキスト埋め込みを生成するために、`bedrock/amazon.titan-embed-text-v2:0`で`EmbeddingFunction`が初期化されます。埋め込み処理には60秒のタイムアウトが設定されています。
- `llm_model`:変数`llm_model`は`bedrock/us.amazon.nova-lite-v1:0`に設定されており、回答の生成に使用されます。
```python
text_embed = EmbeddingFunction(
"bedrock/amazon.titan-embed-text-v2:0",
timeout=60
)
llm_model = "bedrock/us.amazon.nova-lite-v1:0"
```
5. `pytidb.schema.TableModel`を使用して`Chunk`テーブルスキーマが定義されています。この`chunks`という名前のテーブルは、データを格納するために使用されます。
- `id`:プライマリキーとして機能する整数フィールド。
- `text`:生のテキストチャンクを格納する文字列フィールド。
- `text_vec`:先に定義した`text_embed`関数によって生成された`text`フィールドの埋め込みを自動的に格納するベクトルフィールド。
```python
# Define the Chunk table
table_name = "chunks"
class Chunk(TableModel, table=True):
__tablename__ = table_name
__table_args__ = {"extend_existing": True}
id: int = Field(primary_key=True)
text: str = Field()
text_vec: Optional[Any] = text_embed.VectorField(
source_field="text",
)
```
6. `sample_chunks`(文字列)のリストが提供されています。実際のアプリケーションでは、これらのチャンクは通常、「チャンキング」と呼ばれるプロセスを通じて、より大きな文書から派生します。
```python
sample_chunks = [
"Llamas are camelids known for their soft fur and use as pack animals.",
"Python's GIL ensures only one thread executes bytecode at a time.",
# ... (other sample chunks)
"Augmented reality overlays digital content on the real world.",
]
```
7. スクリプトは`chunks`テーブルを開こうとします。テーブルがデータベースに存在しない場合(例えば、初回実行時)、前に定義した`Chunk`スキーマに基づいてテーブルを作成します。これにより、データ操作のためにテーブルが準備されていることが保証されます。
```python
table = db.open_table(table_name)
if table is None:
table = db.create_table(schema=Chunk)
```
8. Streamlitユーザーインターフェースがセットアップされています。ページタイトルは`🔍 RAG Demo`に設定され、サブヘッダー`Database Operations`が追加されています。
```python
st.title("🔍 RAG Demo")
st.subheader("Database Operations")
```
9. データベース操作用のボタン用に2つの列が作成されています:
- `Reset`:クリックすると、このボタンは`chunks`テーブルをトランケート(テーブルからすべてのデータをクリア)し、Streamlitアプリを再実行してビューを更新します。その下に警告メッセージが表示されます。
- `Save Data`:クリックすると、このボタンはテーブルが現在空の場合に`sample_chunks`をテーブルに挿入します。`pytidb`は、`text_vec`フィールドで定義されているように、挿入時にBedrockの埋め込みモデルを自動的に呼び出して`text`データをベクトル化します。その後、アプリは再実行されます。
```python
left, right = st.columns(2)
if left.button("Reset", type="primary"):
left.write("Resetting...")
table.truncate()
st.rerun()
left.markdown("This option will delete all data", unsafe_allow_html=True)
if right.button("Save Data"):
right.write("Saving...")
# insert sample chunks
if table.rows() == 0:
chunks = [Chunk(text=text) for text in sample_chunks]
table.bulk_insert(chunks)
st.rerun()
```
10. `📁 All Chunks in the Database`というラベルの付いた展開可能なセクションが作成されます。展開されると、`table`からすべての行を照会し、データをPandas DataFrameに変換して表示します。テーブルが空の場合は、情報メッセージが表示されます。
```python
with st.expander("📁 All Chunks in the Database", expanded=False):
chunks = table.query()
if chunks:
data = [{'id': chunk.id, 'text': chunk.text, 'text_vec': chunk.text_vec} for chunk in chunks]
df = pd.DataFrame(data)
st.dataframe(df)
else:
st.info("No data found in database.")
```
11. 指示テキストとユーザー入力要素が追加されています:
- ラジオボタン(`mode`)により、ユーザーは操作モードを選択できます:`Retrieval Only`(検索のみ)または`RAG Q&A`。
- サイドバーのスライダー(`query_limit`)で、取得するチャンクの数を調整できます(デフォルトは5、最小1、最大20)。
- テキスト入力ボックス(`query`)で、ユーザーに質問の入力を促します。
```python
st.write(
"Enter your question, and the system will retrieve relevant knowledge and generate an answer"
)
mode = st.radio("Select Mode:", ["Retrieval Only", "RAG Q&A"])
query_limit = st.sidebar.slider("Retrieval Limit", min_value=1, max_value=20, value=5)
query = st.text_input("Enter your question:", "")
```
12. このブロックは、ユーザーが`Send`ボタンをクリックし、クエリを入力した場合のロジックを処理します:
- 処理中にスピナーが表示されます。
- 中核となる操作`table.search(query).limit(query_limit)`は、ユーザーのクエリを使用して`text_vec`列でベクトル類似性検索を実行し、最も類似度の高い上位`query_limit`個のチャンクを取得します。
```python
if st.button("Send") and query:
with st.spinner("Processing..."):
# Retrieve relevant chunks
res = table.search(query).limit(query_limit)
```
13. 選択された`mode`と結果(`res`)が見つかった場合に基づいて:
- `Retrieval Only`の場合:取得されたチャンク(Pandas DataFrameに変換されたもの)を直接表示します。
- `RAG Q&A`の場合:
- 取得されたチャンクから`text`コンテンツが抽出されます。
- これらのテキストを結合して`context`が構築されます。
- `RAG_PROMPT_TEMPLATE`がこの`context`とユーザーの`question`でフォーマットされます。
- Bedrock LLM(`llm_model`で指定)が`litellm.completion`を通じて構築されたプロンプトで呼び出され、回答を生成します。
- LLMの応答はカスタムCSSでスタイリングされて表示されます。
- 展開可能なセクション(`📚 Retrieved Knowledge`)は、回答の生成に使用されたチャンクを表示します。
- 初期検索で結果が返されない場合、情報メッセージ`No relevant information found`が表示されます。
```python
if res:
if mode == "Retrieval Only":
st.write("### Retrieval Results:")
st.dataframe(res.to_pandas())
else:
text = [chunk.text for chunk in res.to_rows()]
# Build RAG prompt
context = "\n".join(text)
prompt = RAG_PROMPT_TEMPLATE.format(context=context, question=query)
# Call LLM to generate answer
response = completion(
model=llm_model,
messages=[{"content": prompt, "role": "user"}],
)
st.markdown(f"### 🤖 {llm_model}")
st.markdown(
"""
""",
unsafe_allow_html=True,
)
# show the response
st.markdown(
f'{response.choices[0].message.content}
',
unsafe_allow_html=True,
)
with st.expander("📚 Retrieved Knowledge", expanded=False):
st.dataframe(res.to_pandas())
else:
st.info("No relevant information found")
```
## モジュール 3: Text2SQL デモアプリケーションの実行、体験、および学習
次のデモでは、別の種類の GenAI アプリケーションについて掘り下げます。このアプリケーションは TiDB Cloud Serverless クラスタを SQL 検証ツールとして使用します。次のことを行います:
1. クエリから SQL を生成します。
2. TiDB Cloud Serverless クラスタで実行します。
3. TiDB Cloud Serverless クラスタからフィードバックまたはエラーメッセージを取得します。
4. 確実な結果が得られるまで自己修正を行います。
### 手順 1. Text2SQL Streamlit サービスを実行する
新しいターミナルを作成します:

次に、`streamlit` コマンドラインツールを使用してこのスクリプトを実行します:
```bash
streamlit run bedrock/text2sql.py --server.port 8502
```
```output
Collecting usage statistics. To deactivate, set browser.gatherUsageStats to false.
You can now view your Streamlit app in your browser.
Local URL: http://localhost:8502
Network URL: http://172.17.0.2:8502
External URL: http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8502
```
### 手順 2. Text2SQL デモウェブページを使用する
- [Text2SQL デモウェブページ](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:8502/)を開きます。

- 次に、このデータセットについて質問することができます。例えば:
```text
How many tables in the database?
```
- Enter キーをクリックして SQL を生成し、TiDB Cloud Serverless クラスタで実行します。

- または、次のような別の質問を試すこともできます:
```text
What is the table name in the database?
```

- これはモジュール 2 を実行し、そこで `chunks` テーブルを作成したためです。
- このデータセットについて質問したいことを自由に試してみてください。
### 手順 3. Text2SQL デモコードの読み取り
再度、[VS Code](http://${LAB:HOST_MONITOR1_PUBLIC_IP}:3000/?folder=/root/tidb-lab-ai) に戻り、コードファイル `bedrock/text2sql.py` をクリックします。
1. スクリプトは必要なライブラリをインポートします:環境変数用の `os`、AWS サービス(特に Bedrock)と対話するための `boto3`、UI 用の `streamlit`、そしてデータベース接続用の `pytidb` から `TiDBClient` をインポートします。
```python
#!/usr/bin/env python
# -*- coding: utf-8 -*-
import os
import boto3
import streamlit as st
from pytidb import TiDBClient
```
2. Streamlitアプリケーションページのタイトル `## 📖 Text2SQL` が設定されています。
```python
st.markdown("## 📖 Text2SQL")
```
3. `TiDBClient` 接続が TiDB Cloud Serverless クラスタに確立されます。接続の詳細(ホスト、ポート、ユーザー、パスワード、データベース)は環境変数から読み取られます。接続には SSL が有効になっています。
```python
db = TiDBClient.connect(
host=os.getenv("SERVERLESS_CLUSTER_HOST"),
port=int(os.getenv("SERVERLESS_CLUSTER_PORT")),
username=os.getenv("SERVERLESS_CLUSTER_USERNAME"),
password=os.getenv("SERVERLESS_CLUSTER_PASSWORD"),
database=os.getenv("SERVERLESS_CLUSTER_DATABASE_NAME"),
enable_ssl=True,
)
```
4. Amazon Bedrock ランタイム用の `boto3` クライアントが初期化され、特に `us-west-2` リージョンに設定されています。このクライアントは Bedrock モデルを呼び出すために使用されます。
```python
client = boto3.client(
service_name="bedrock-runtime",
region_name="us-west-2"
)
```
5. Streamlit のセッション状態がチャット履歴を保存するために初期化されます。`generated`(アシスタントのメッセージ用)と `past`(ユーザーのメッセージ用)という2つのリストが、まだ存在しない場合に作成されます。
```python
for item in ["generated", "past"]:
if item not in st.session_state:
st.session_state[item] = []
```
6. テーブル定義が接続されたTiDBデータベースから取得されます。スクリプトはすべてのテーブル名を反復処理し、それぞれに対して`SHOW CREATE TABLE`を実行し、DDLステートメントを`table_definitions`リストに格納します。`current_database`名も取得されます。この情報はLLMにスキーマのコンテキストを提供します。
```python
table_definitions = []
current_database = db._db_engine.url.database
for table_name in db.table_names():
table_definitions.append(db.query(f"SHOW CREATE TABLE `{table_name}`").to_rows()[0])
```
7. ヘルパー関数 `format_answer` が定義されています。この関数は、LLMのレスポンスから先頭や末尾のコードブロックマーカー(\`\`\`sql や \`\`\` など)を削除して、SQLやマークダウンが整理された状態になるようにします。
```python
def format_answer(answer: str) -> str:
# Handle ```.* specifically
if answer.startswith("```"):
# Find the first newline after the opening ```
first_newline = answer.find("\n")
if first_newline != -1:
# Remove everything from start to the newline
answer = answer[first_newline:].strip()
# Remove closing ``` if present
if answer.endswith("```"):
answer = answer[:-len("```")].strip()
return answer
```
8. `on_submit` 関数が定義されています。この関数はユーザーが質問を送信したときに呼び出されます。
- セッション状態から `user_input` を取得します。
- Amazon Bedrock モデル `us.amazon.nova-pro-v1:0` を `client.converse` を使用して呼び出し、SQL クエリを生成します。システムプロンプトはモデルに上級 DBA として振る舞うよう指示し、提供されたテーブル定義とデータベース名を使用して、余分なテキストなしで直接 SQL で応答するよう指示します。
- 生成された SQL はレスポンスから抽出され、`format_answer` を使用してクリーンアップされます。
- ユーザーの入力は `st.session_state.past` リストに追加されます。
```python
def on_submit():
user_input = st.session_state.user_input
if user_input:
generated_sql = (
client.converse(
modelId="us.amazon.nova-pro-v1:0",
messages=[
{"role": "user", "content": [{"text": f"Question: {user_input}\n Respond in SQL directly, without any other text and format."}]},
],
system=[
{"text": f"""You are a very senior database administrator who can write SQL very well,
please write MySQL SQL to answer user question,
Use backticks to quote table names and column names,
here are some table definitions in database,
the database name is {current_database}\n\n"""
+ "\n".join("|".join(t) for t in table_definitions)}
],
)["output"]["message"]["content"][0]["text"]
)
generated_sql = format_answer(generated_sql)
st.session_state.past.append(user_input)
```
9. `generated_sql` に対して安全性チェックが実行されます。もし `INSERT` または `UPDATE`(大文字小文字を区別しない)が含まれている場合、エラーメッセージが表示され、スクリプトは停止します。これにより、潜在的に有害なDMLステートメントの実行を防止します。
```python
if "insert" in generated_sql.lower() or "update" in generated_sql.lower():
st.error(
"The generated SQL is not a SELECT statement, please check it carefully before running it."
)
st.stop()
```
10. スクリプトは `generated_sql` を TiDB データベースに対して実行しようとします:
- `try-except` ブロックがクエリ実行中の潜在的なエラーを処理します。
- 成功した場合、データベースクエリの結果(`rows`)が取得され、文字列 `sql_result` に整形されます。
- Bedrock モデル `us.amazon.nova-pro-v1:0` への別の呼び出しが行われます。今回、LLM はマークダウンフォーマッターとして機能するよう指示されます。元の質問、生成された SQL、および `sql_result` を入力として受け取り、データのマークダウンテーブルを含む読みやすいマークダウンレスポンスに整形するよう求められます。また、コードブロックなどの余分な書式を避けるよう指示されています。
- LLM の整形された回答は `format_answer` を使用してクリーンアップされ、`st.session_state.generated` に追加されます。
- このプロセス中に例外が発生した場合、エラーメッセージが `st.session_state.generated` に追加されます。
```python
# Execute the SQL query and set the result
answer = None
try:
rows = db.query(generated_sql).to_rows()
sql_result = "\n".join(str(row) for row in rows)
answer = (
client.converse(
modelId="us.amazon.nova-pro-v1:0",
messages=[
{"role": "user", "content": [{"text": f"""
Question: {user_input}\n\n
SQL: {generated_sql}\n\n
Result: {sql_result}"""}]},
],
system=[
{"text": """You are a markdown formatter,
format the Question and SQL to markdown text,
format the data row into markdown tables.
NOTE: Without any other format like ``` etc.
"""}
],
)["output"]["message"]["content"][0]["text"]
)
answer = format_answer(answer)
st.session_state.generated.append(answer)
except Exception as e:
st.session_state.generated.append(f"Error: {e}")
```
11. ユーザー操作のためのStreamlit UIがセットアップされます:
- サブヘッダー `##### User Query` が表示されます。
- `st.container` がチャット入力とチャット表示エリアをグループ化します。
- `st.chat_input` はユーザーの質問用のテキスト入力フィールドを作成します。`key="user_input"` はセッション状態にバインドし、`on_submit=on_submit` はコールバック関数にリンクします。
- `st.empty()` はチャット履歴が表示されるプレースホルダー(`chat_placeholder`)を作成します。
```python
st.markdown("##### User Query")
with st.container():
st.chat_input(
"Input your question, e.g. how many tables in the database?",
key="user_input",
on_submit=on_submit,
)
chat_placeholder = st.empty()
```
12. チャット履歴は `chat_placeholder` コンテナ内にレンダリングされます:
- `st.session_state["generated"]`(アシスタントの応答)と `st.session_state["past"]`(ユーザーの入力)リストを逆時系列順(最新のものが最初)に繰り返し処理します。
- `st.chat_message("user")` と `st.chat_message("assistant")` は、適切なスタイルで各メッセージを表示するために使用されます。
```python
with chat_placeholder.container():
for i in range(len(st.session_state["generated"]) - 1, -1, -1):
with st.chat_message("user"):
st.write(st.session_state["past"][i])
with st.chat_message("assistant"):
st.write(st.session_state["generated"][i])
```
### 手順 4. TiDB Cloud コンソールにアクセスして独自の旅を始めましょう
+ 独自のAWSアカウントの作成とAmazon Bedrockの設定は、この演習の範囲外です。詳細については、[Amazon Bedrockのドキュメント](https://docs.aws.amazon.com/bedrock/latest/userguide/what-is-bedrock.html)を参照してください。
+ TiDBとそのコンパニオンGenAI SDK「pytidb」は、GenAIアプリケーション用の統合データストアを提供することで開発を簡素化します。[こちら](https://tidbcloud.com/clusters)から TiDB Cloud の旅を始めることができます。この演習で自分の無料のクラスタを使用した場合は、同じページに表示されています。クラスタ名は ${LAB:SERVERLESS_CLUSTER_NAME} です。
## 結論
この演習では、Python、統合データストアとしてのTiDB Cloud Serverless、およびAmazon Bedrockを使用して2種類のAIアプリケーションを構築する方法を学びました:
- **検索拡張生成(RAG):** `pytidb`を使用してTiDB Cloud Serverlessに接続し、Amazon Bedrockの`bedrock/amazon.titan-embed-text-v2:0`モデルによって生成されたベクトル埋め込みとともにテキストデータを保存し、ベクトル類似性検索を実行して関連するコンテキストを取得し、`bedrock/us.amazon.nova-lite-v1:0`のような大規模言語モデル(LLM)を使用して取得したコンテキストに基づいて回答を生成する方法を学びました。また、RAGシステムと対話するためのStreamlitインターフェースも構築しました。
- **テキストからSQL:** LLM(`bedrock/us.amazon.nova-pro-v1:0`)を活用して自然言語の質問をSQLクエリに変換する方法を探りました。正確なSQL生成のためにLLMにTiDBからのテーブルスキーマをコンテキストとして提供し、生成されたクエリをTiDBに対して実行し、別のLLM呼び出しを使用して結果をフォーマットする方法を学びました。このアプリケーションもStreamlitインターフェースを通じて提示されました。
```hbsptform
{
"ui": {
"titleLevel": 3
},
"portalId": "4466002",
"formId": "62bfb32a-a60a-4f9d-b2dc-1107a93db568",
"region": "na1",
"sfdcCampaignId": "701RC00000NdFlAYAV"
}
```